Sigmoid-Spline-Experiment
AktivEin PyTorch-Experiment über verschwindende Gradienten. Ich vergleiche eine mit Splines modifizierte Sigmoid-Funktion mit ReLU und Sigmoid und untersuche, was beim Training tiefer Netze passiert.
- Begonnen
- 2025-07-08
- Aktualisiert
- 2025-09-15

Hintergrund & Motivation
Im Jahr 2025 wollte ich im Rahmen meines Studiums tiefer in die mathematischen Grundlagen neuronaler Netze eintauchen. Mein Fokus lag auf dem klassischen Vanishing Gradient Problem (VGP). Während moderne Netze standardmäßig auf ReLU setzen, um dieses Problem zu umgehen, wollte ich untersuchen, ob die theoretisch “veraltete” Sigmoid-Funktion durch eine mathematische Modifikation rehabilitiert werden kann.
Die Idee basierte auf Inhalten meiner Mathematik-Vorlesung: Die Verwendung von kubischen hermiteschen Splines, um das Sättigungsverhalten der Sigmoid-Funktion zu verändern. Ziel war es, den Gradientenfluss auch in sehr tiefen Netzen “künstlich” am Leben zu erhalten.
Methodik: Das “Worst-Case-Szenario”
Um das VGP isoliert betrachten und die Effekte der Aktivierungsfunktionen sauber messen zu können, habe ich ein Szenario konstruiert, das das Verschwinden von Gradienten provoziert:
- Modellarchitektur: Ein tiefes Feedforward MLP mit 16 Hidden Layers (à 512 Neuronen).
- Isolierung: Ich habe bewusst auf moderne Hilfsmittel wie Residual Connections, Batch Normalization und Dropout verzichtet. Das Netz ist somit vollständig auf die Aktivierungsfunktion angewiesen, um den Signalfluss aufrechtzuerhalten.
- Training: 250 Epochen mit dem Adam Optimizer auf einer NVIDIA RTX 4070 Ti Super.
Verglichen wurden ReLU (Standard), Sigmoid (Baseline) und mein Optimized-Sigmoid-Spline.
Die Spline-Modifikation
Mein Ansatz (“Optimized-Sigmoid-Spline”) approximiert im Kernbereich die Sigmoid-Kurve durch Splines. Im äußeren Bereich wird die Funktion jedoch linear fortgesetzt. Dies verhindert, dass die Ableitung gegen 0 strebt, was bei der klassischen Sigmoid-Funktion der Hauptgrund für sterbende Gradienten ist.
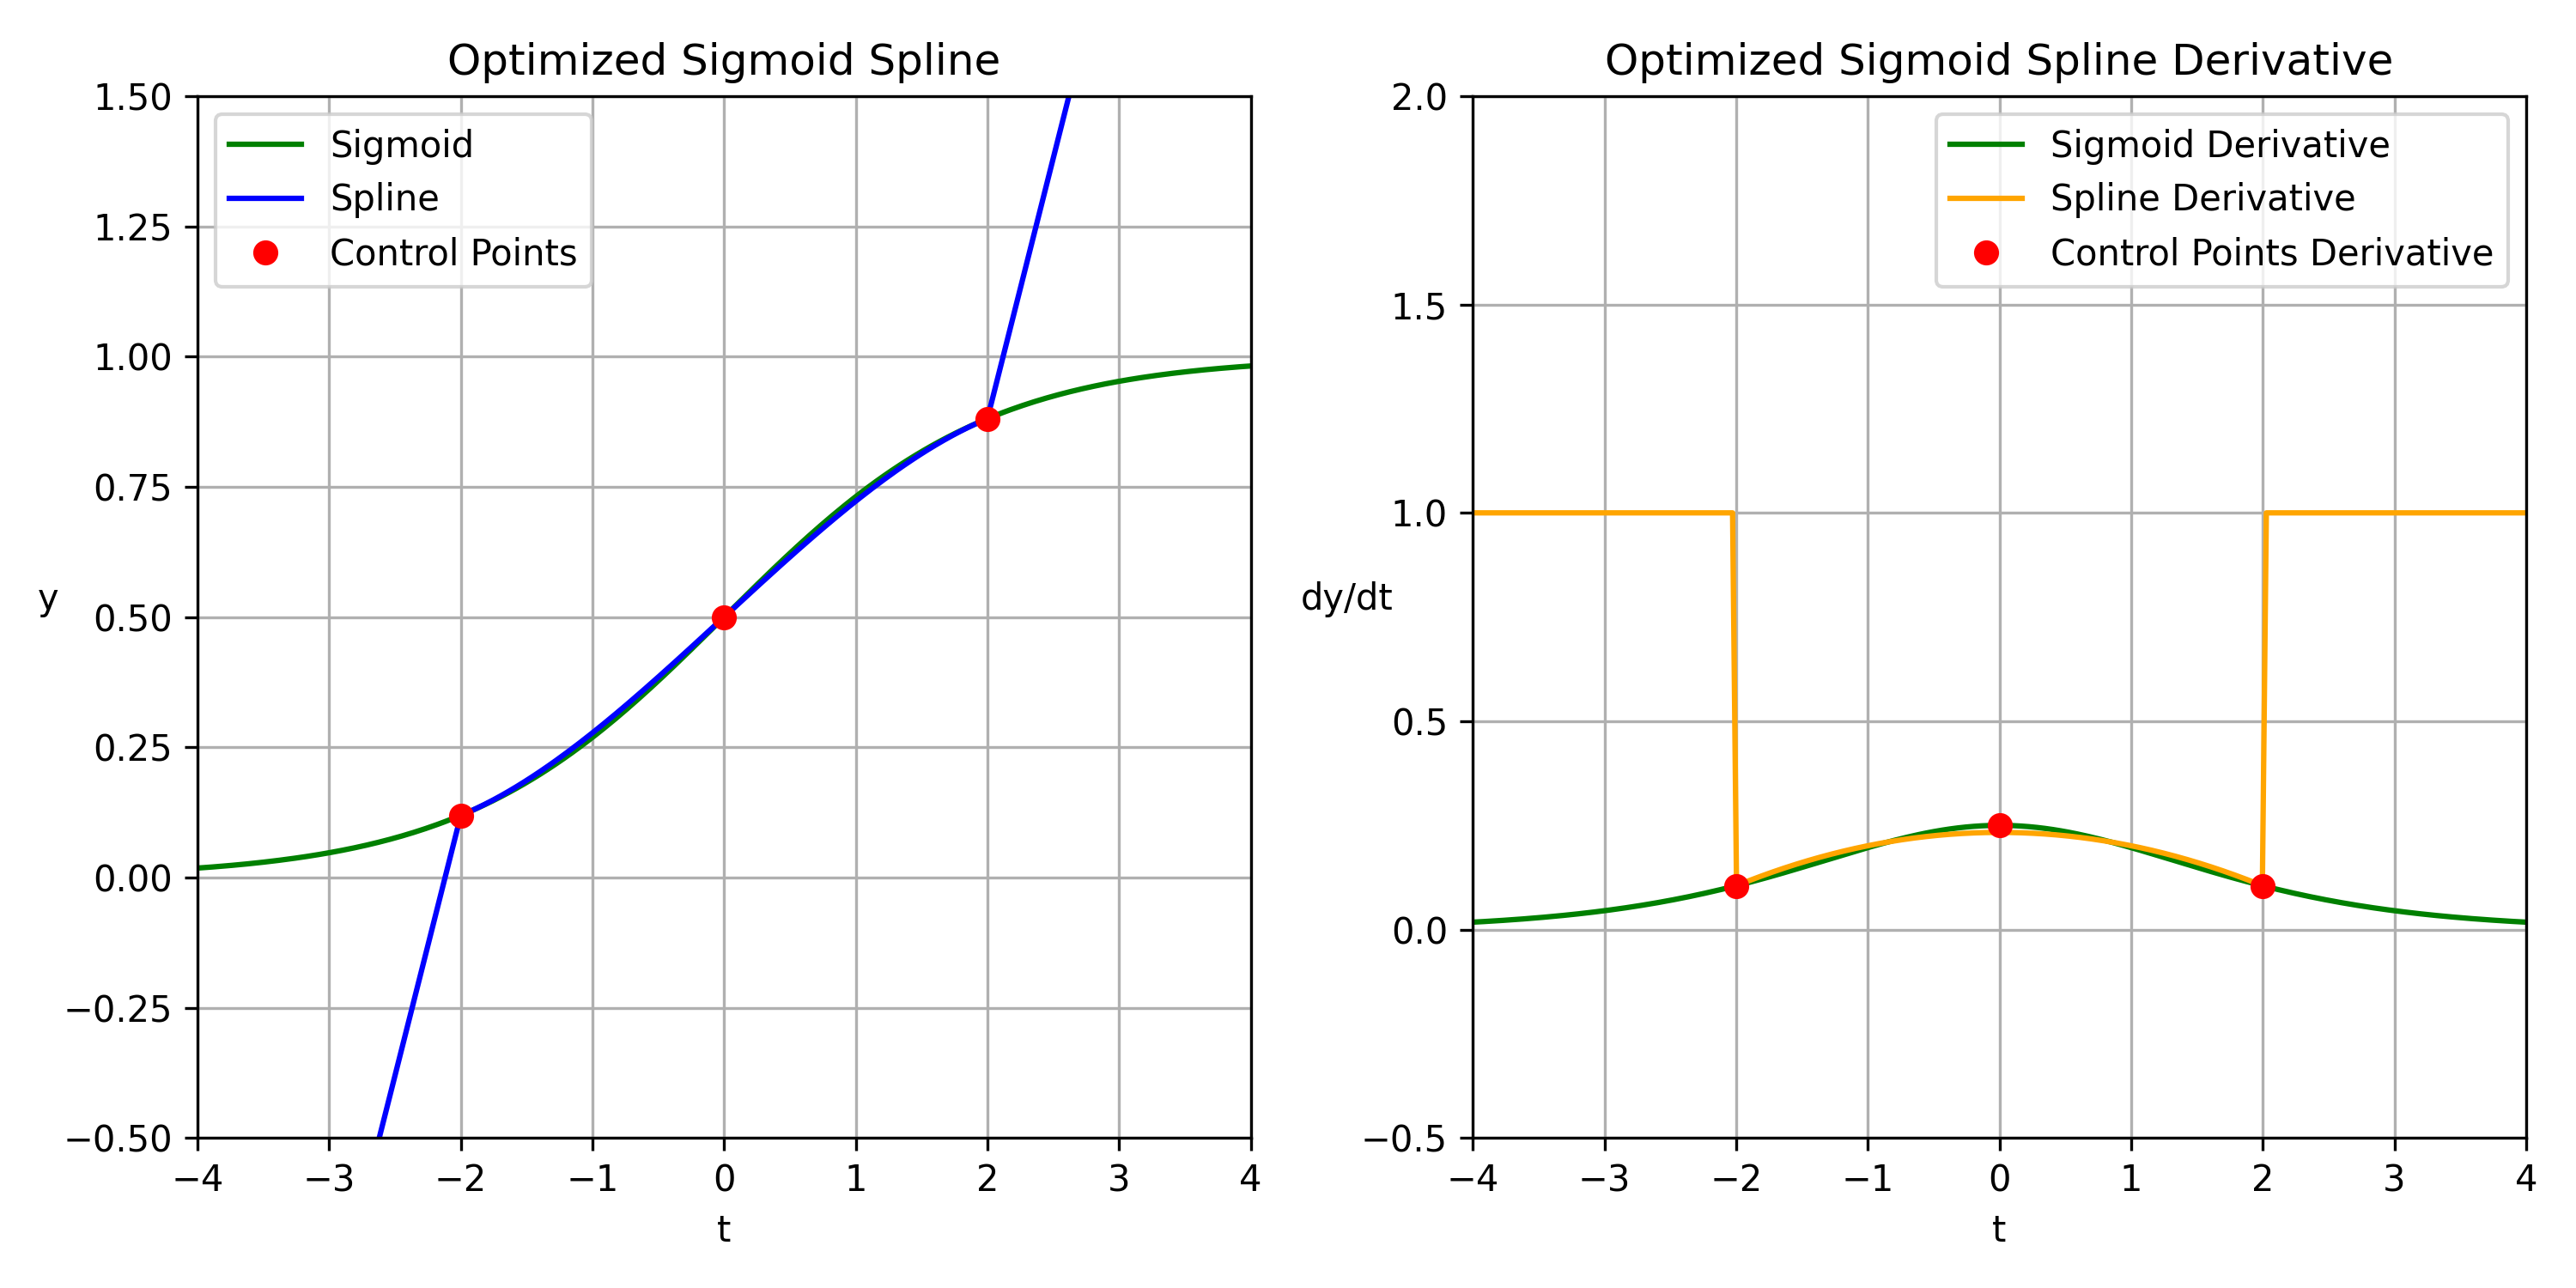
Abb 1: Funktionsverlauf (links) und Ableitung (rechts). Die lineare Fortsetzung an den Rändern verhindert, dass die Ableitung gesättigt wird (rechts, orange Linie), und hält so die Gradienten am Leben.
Ergebnisse
Die Experimente auf FashionMNIST, CIFAR-10 und Tiny ImageNet-200 lieferten spannende Einblicke in die Trainingsdynamik.
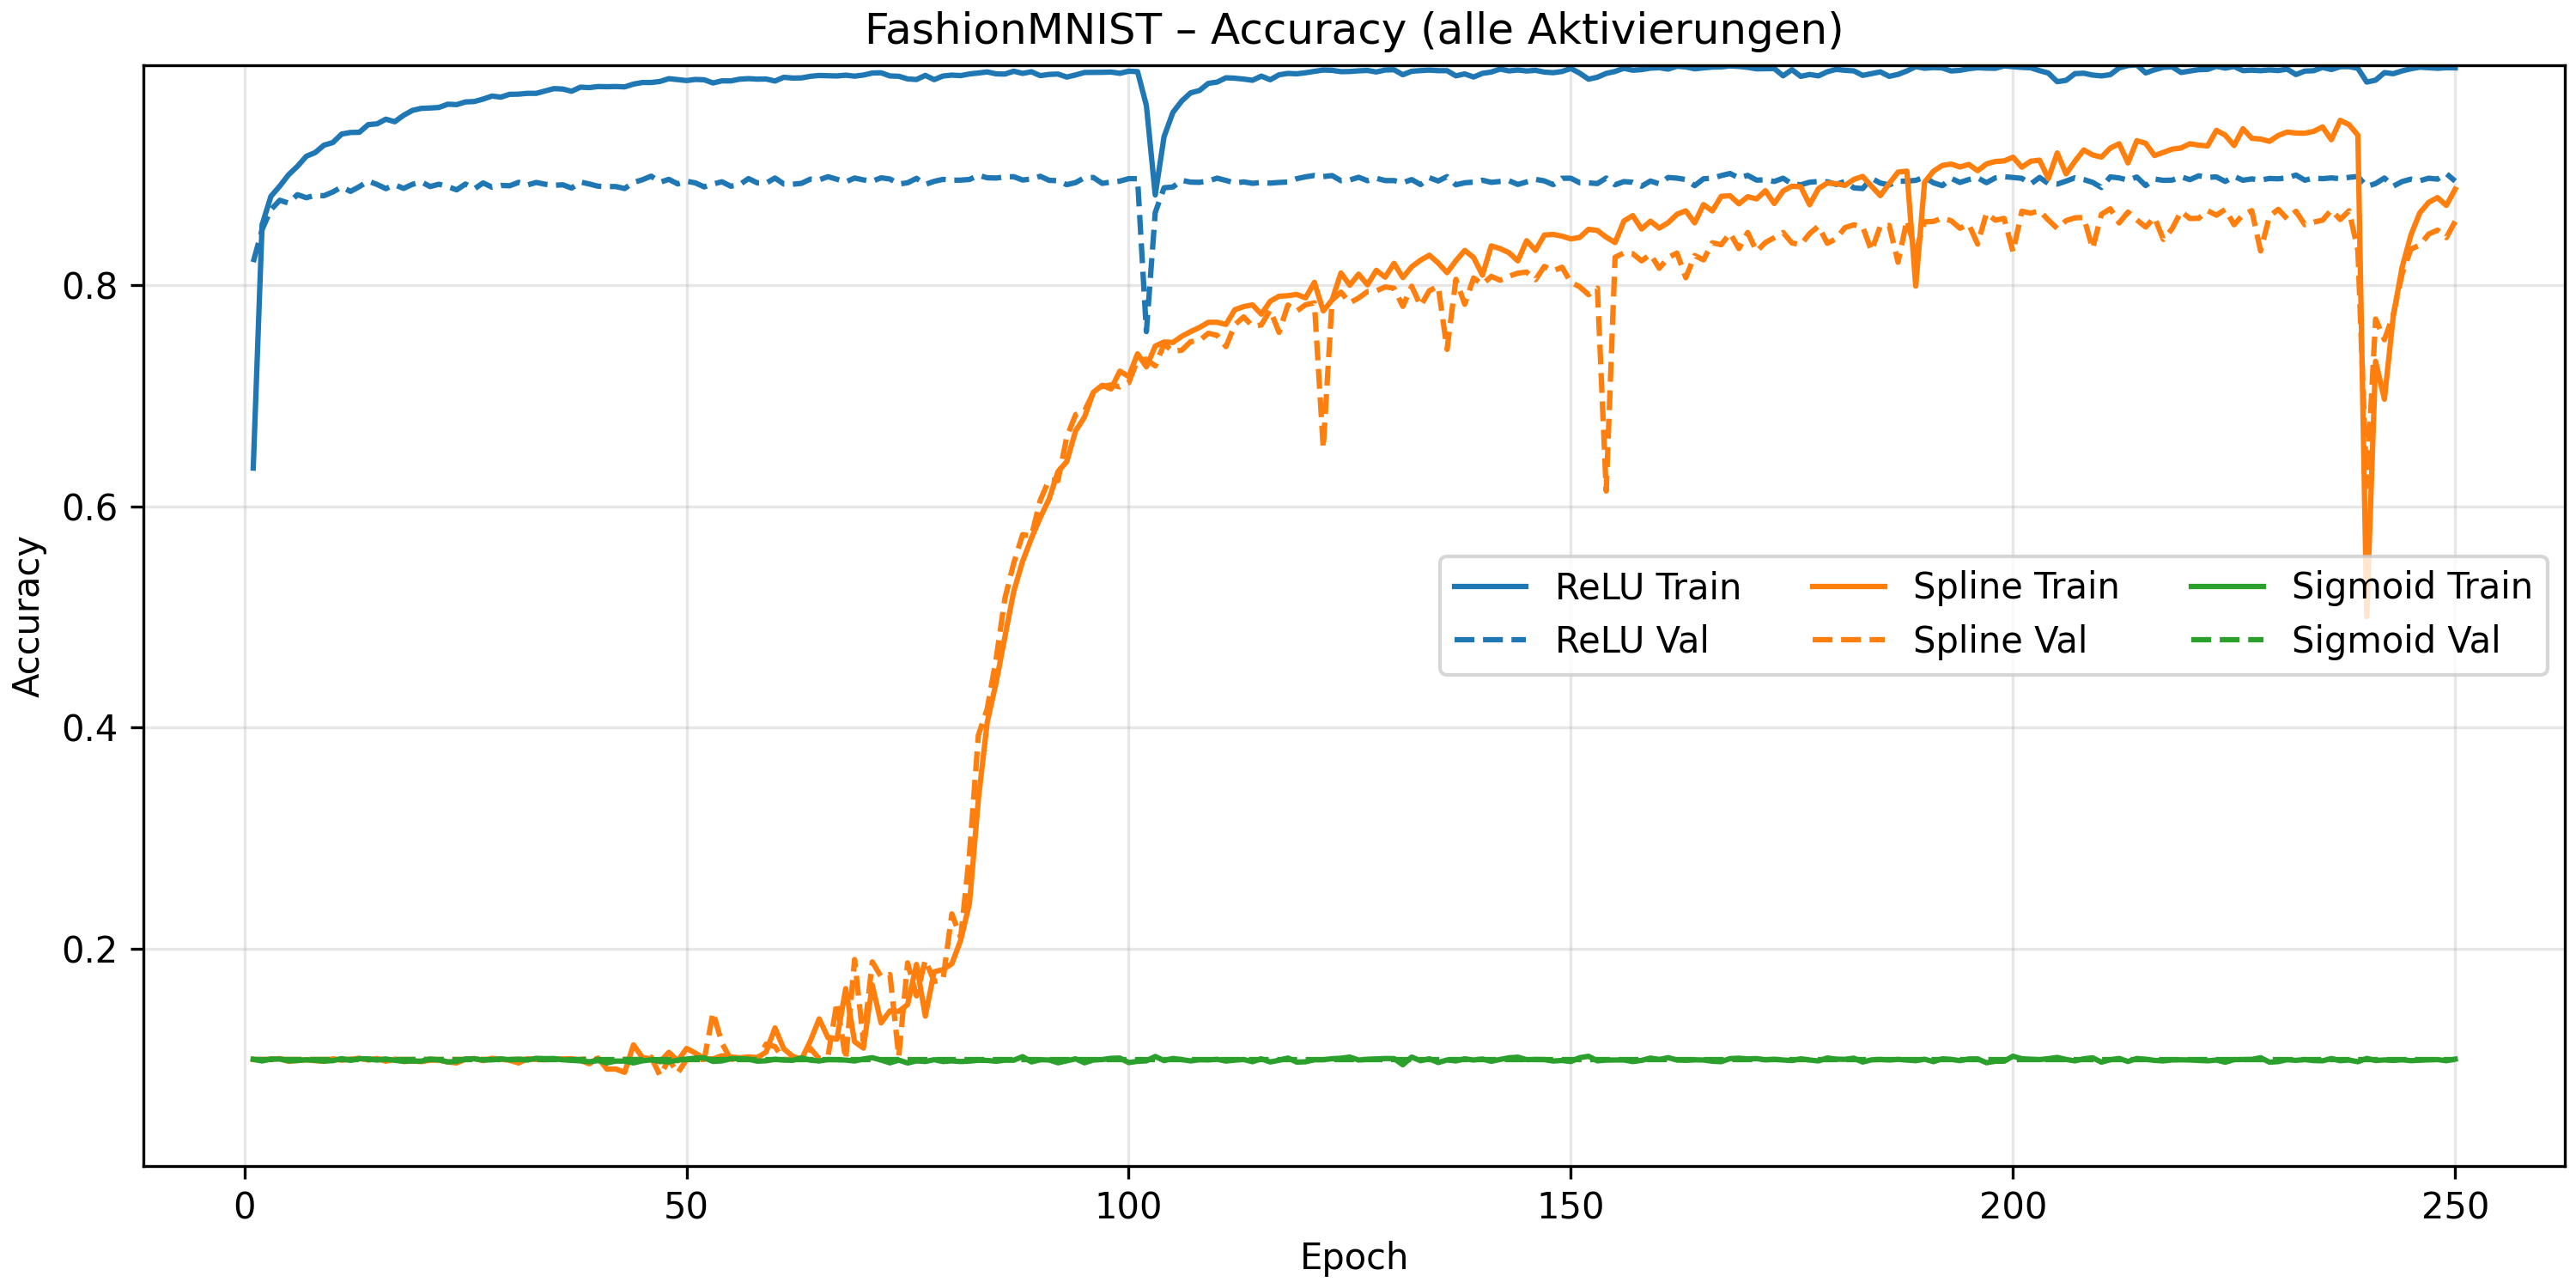
Abb 2: Vergleich der Validierungs-Genauigkeit. Man sieht deutlich, wie die Spline-Variante (orange) nach einer Einschwingphase fast zu ReLU (blau) aufschließt, während Sigmoid (grün) am Boden bleibt.
| Datensatz | ReLU (Standard) | Sigmoid (Baseline) | Spline (Mein Ansatz) |
|---|---|---|---|
| FashionMNIST | 90.1 % | 10.0 % (Lernstopp) | 86.9 % |
| CIFAR-10 | 53.9 % | 10.0 % | 13.1 % |
| Tiny ImageNet | 8.4 % | 0.5 % | 8.9 % |
Analyse der Gradienten
Hier zeigt sich der eigentliche Effekt der Arbeit.
1. Sigmoid scheitert: Wie theoretisch erwartet, führte die klassische Sigmoid-Funktion in diesem tiefen Netz zum Totalausfall. Die Gradienten fielen auf etwa 10⁻¹¹, das Netz lernte nichts mehr und verharrte auf Zufallsniveau.
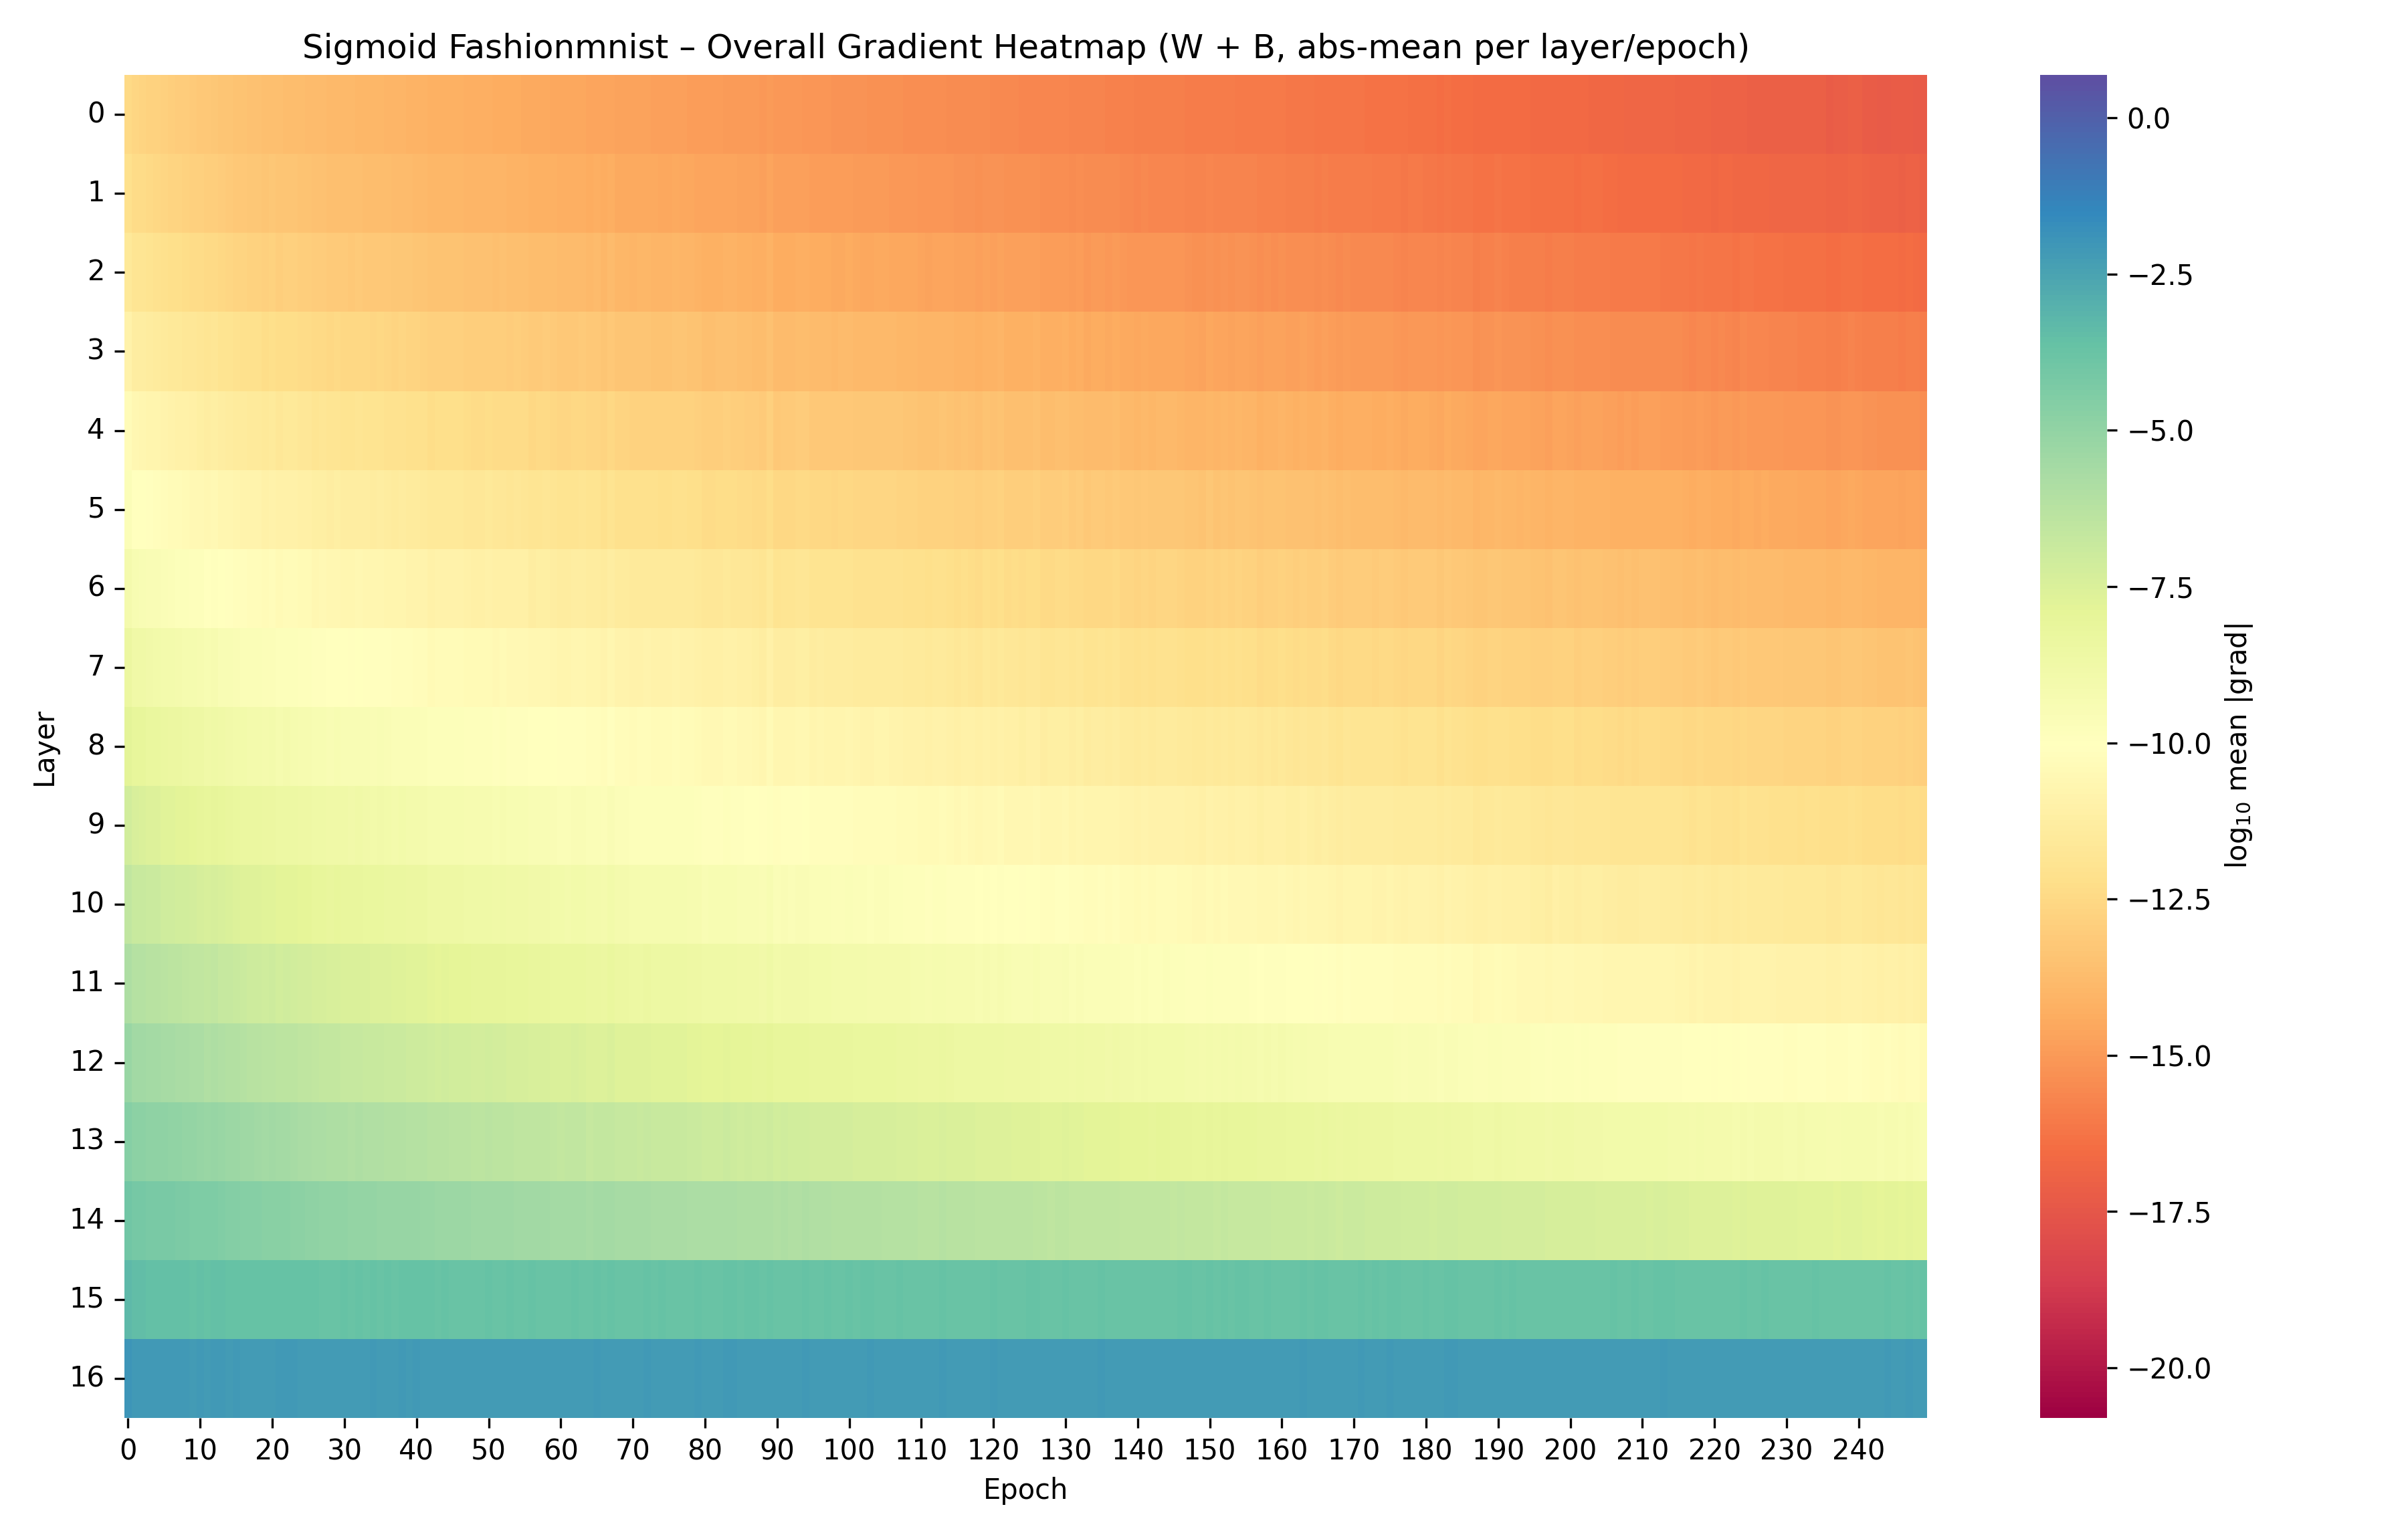
Abb 3: Sigmoid Heatmap. Alles ist “kalt” (dunkelblau/türkis), die Gradienten sind tot.
2. Spline reaktiviert den Fluss: In den untersuchten FashionMNIST-Läufen blieb der Gradientenfluss mit der Spline-Variante gegenüber der klassischen Sigmoid-Funktion erhalten. Die Heatmaps der Gradienten zeigten, dass der Spline-Ansatz auch in frühen Schichten stabile Gradienten lieferte.
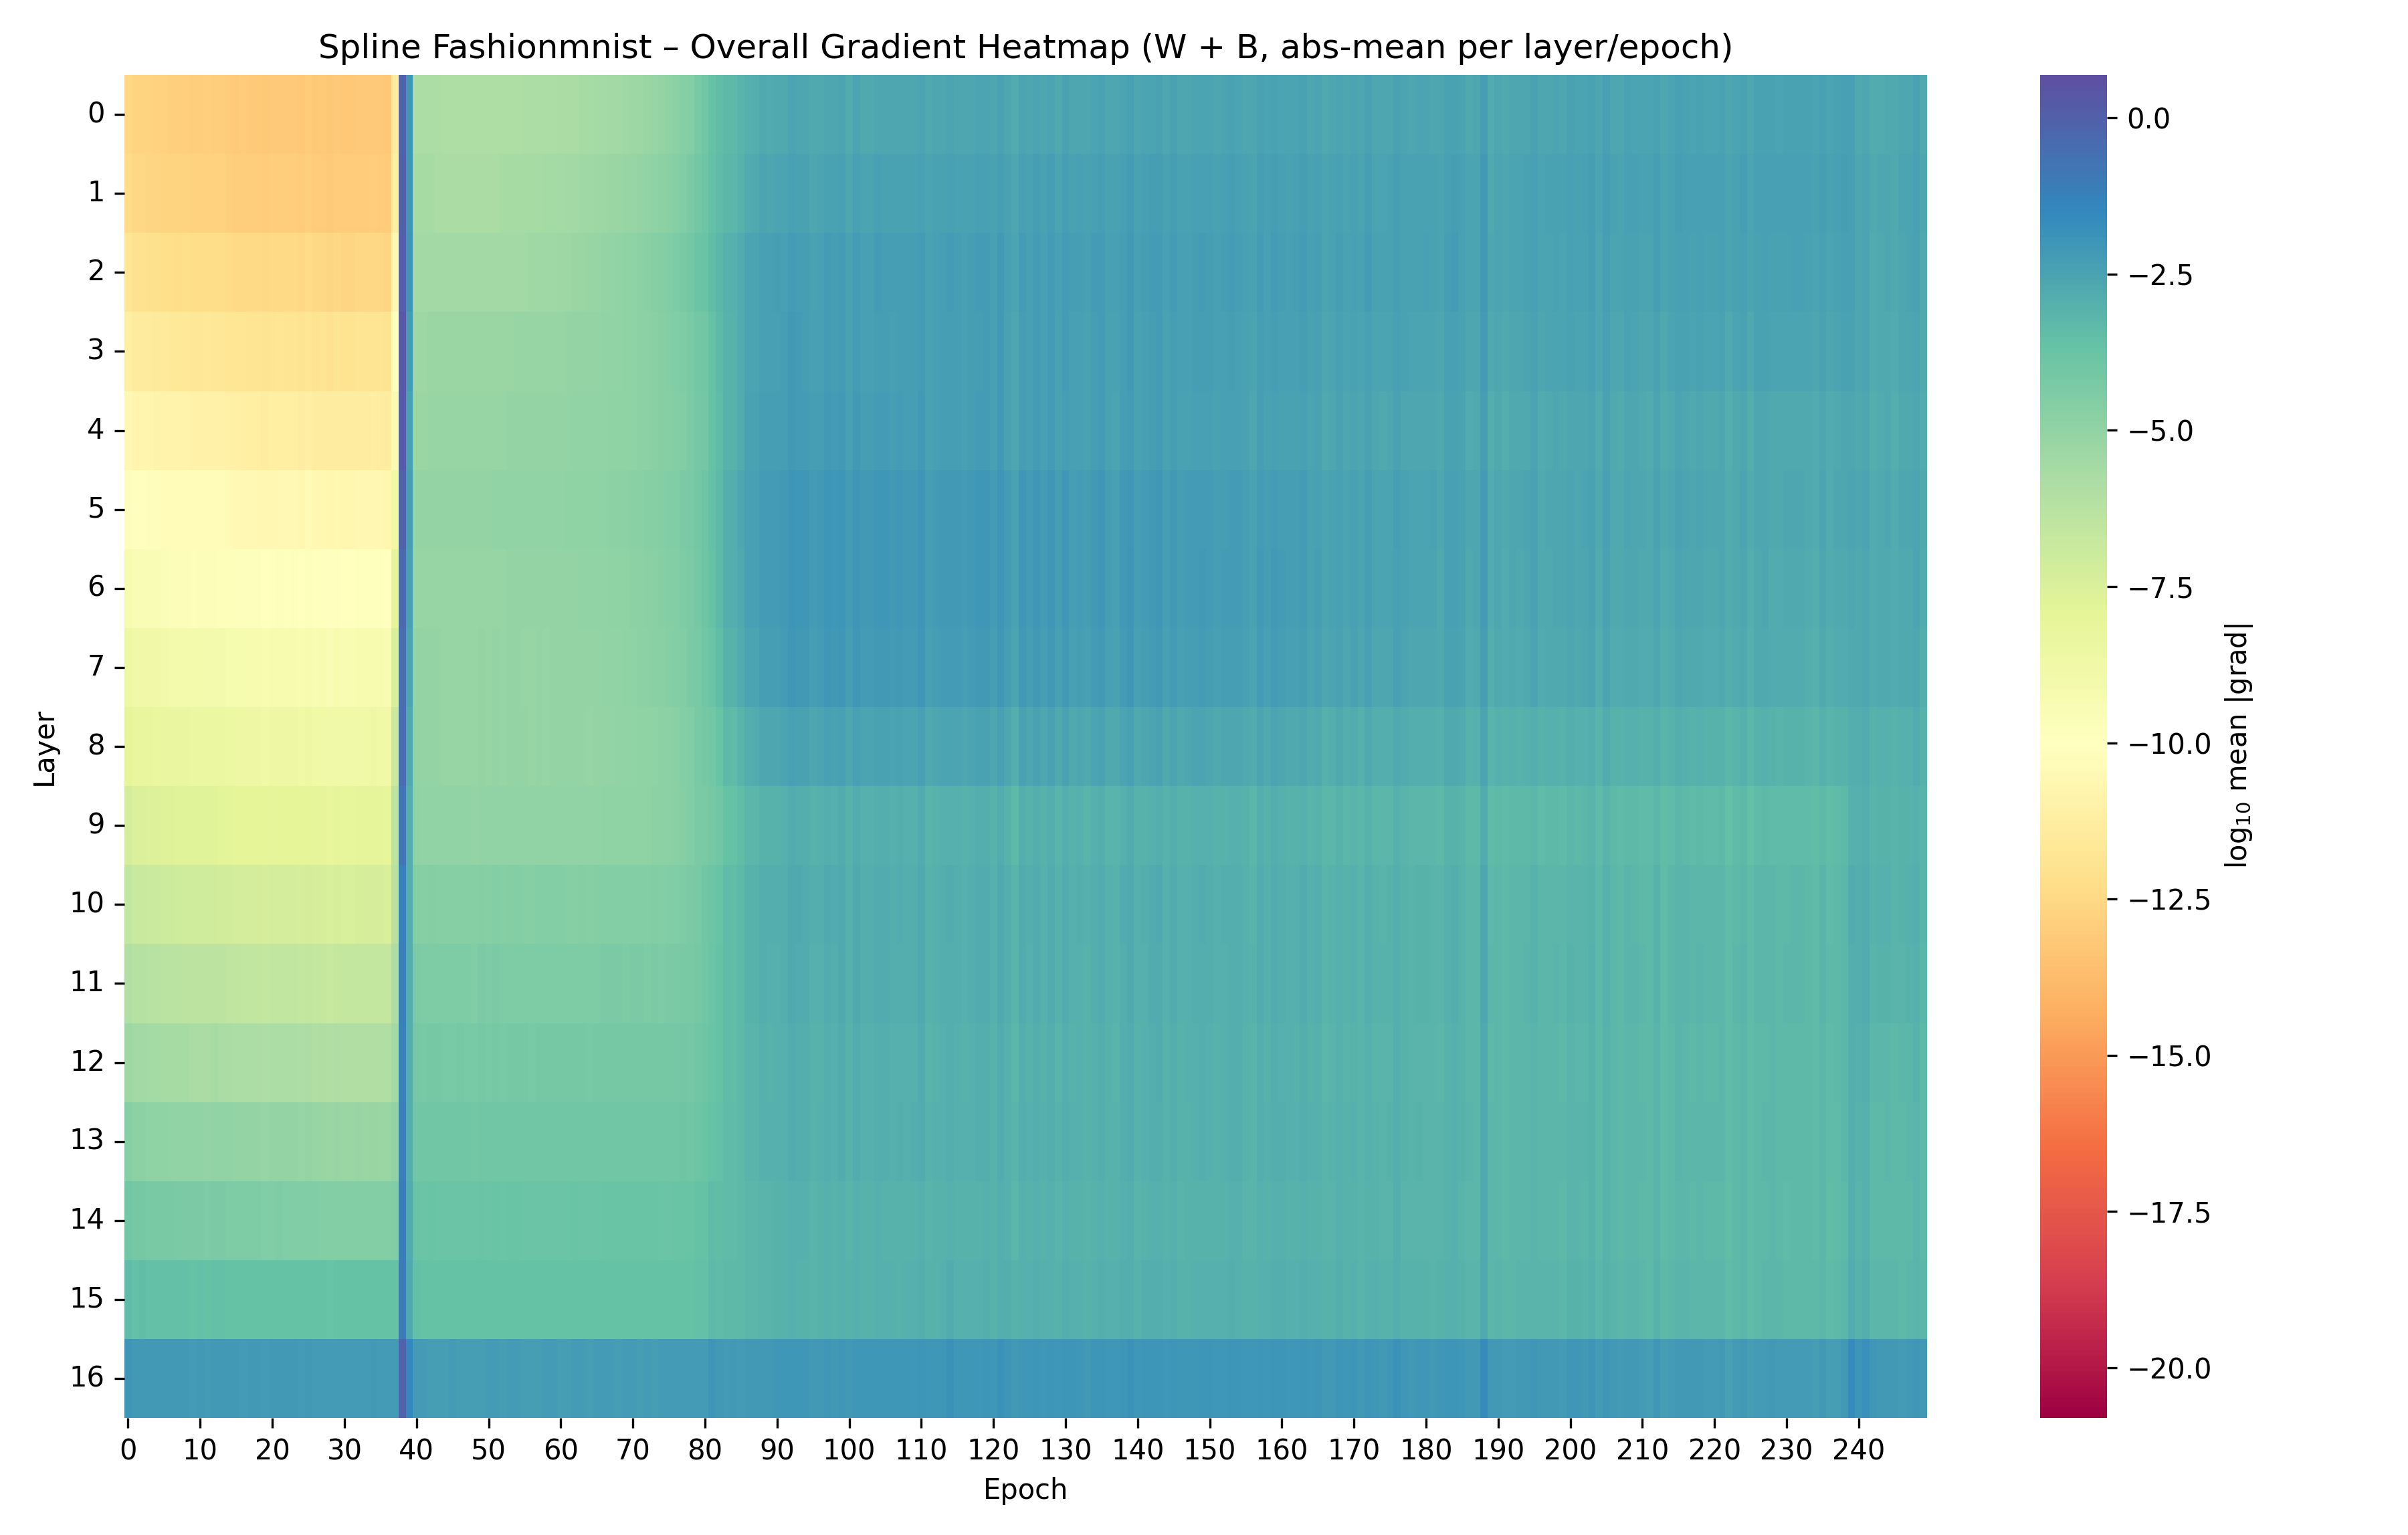
Abb 4: Spline Heatmap. Hier sieht man deutlich “wärmere” Farben (Gelb/Grün) und vertikale Bänder, die zeigen, dass Signale durch das tiefe Netz propagiert werden.
3. Grenzen der Architektur: Auf den komplexeren Datensätzen (CIFAR-10, Tiny ImageNet) war das einfache MLP-Modell generell überfordert. Während ReLU hier starkes Overfitting zeigte (hohe Trainings-, niedrige Validierungs-Accuracy), verhielt sich der Spline-Ansatz zwar stabil, konnte aber aufgrund der limitierten Modellarchitektur keine Wunder bewirken.
Fazit & Performance
In diesem Versuchsaufbau verbesserte die Spline-Modifikation den Gradientenfluss gegenüber der klassischen Sigmoid-Funktion. Daraus folgt keine allgemeine Lösung des Vanishing Gradient Problems. Die Klassifikationsgüte hing deutlich vom Datensatz ab, und die höhere Rechenzeit gehört zur Bewertung des Ansatzes dazu.
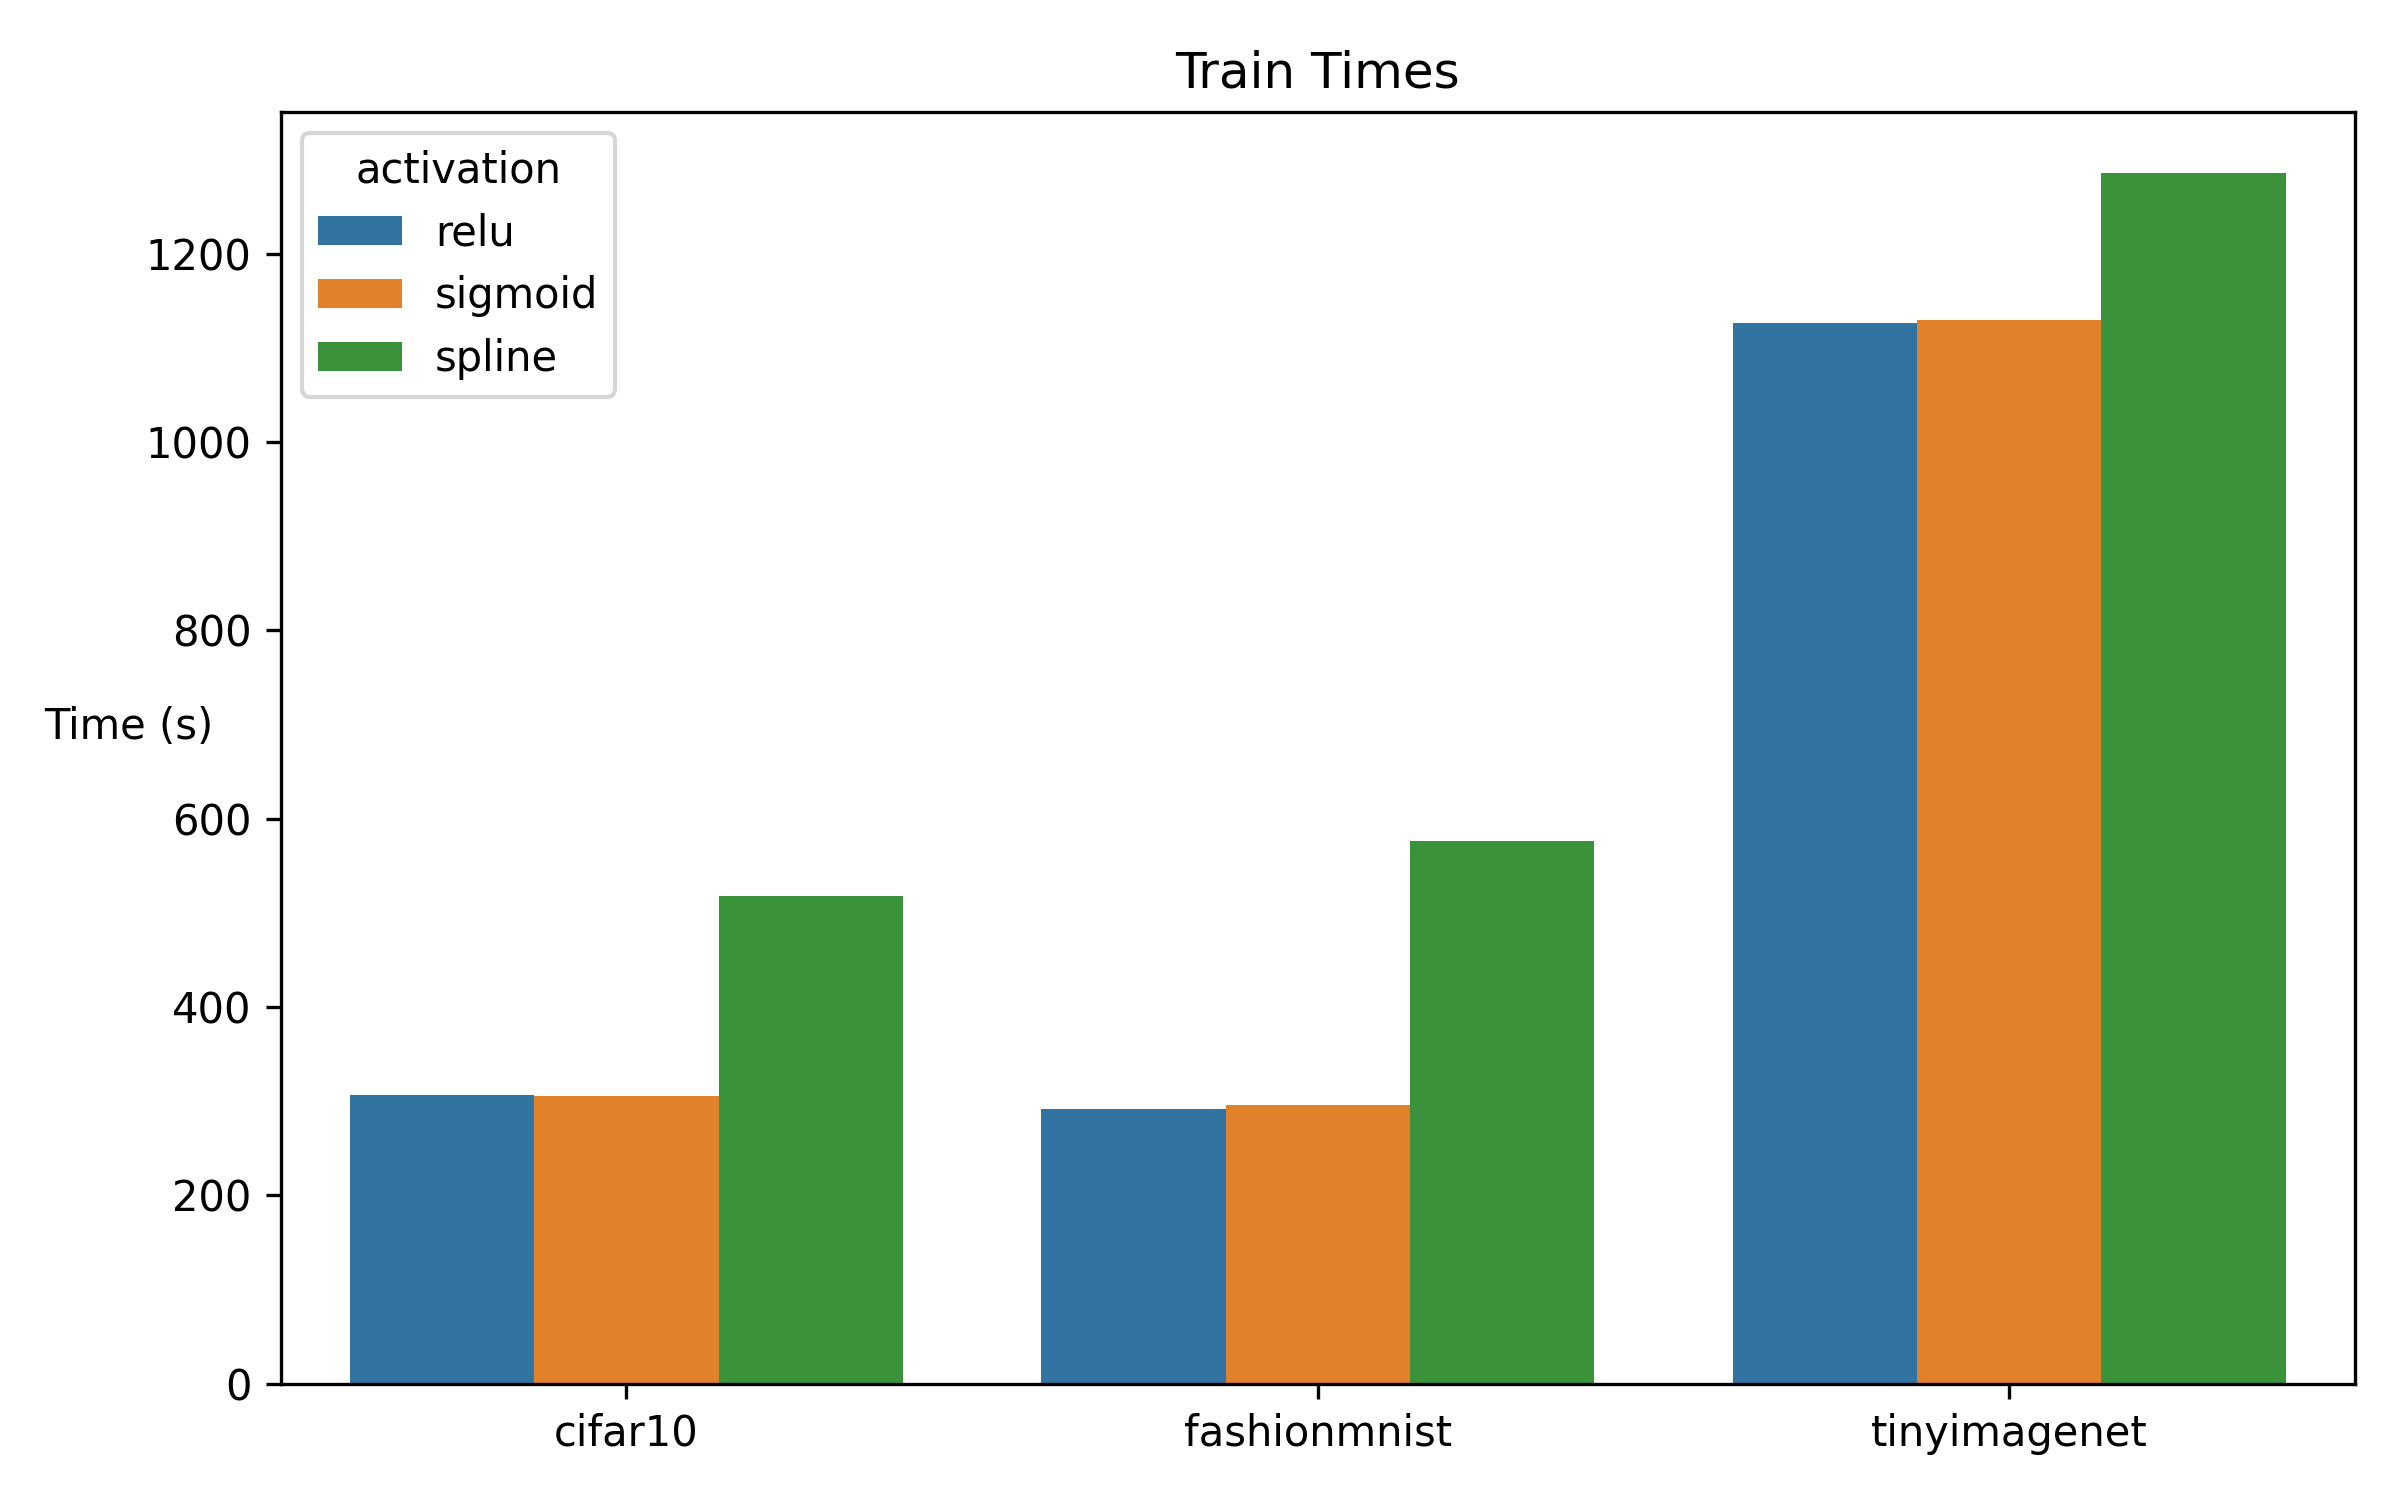
Abb 5: Trainingszeiten im Vergleich. Der Spline-Ansatz (grün) ist rechenintensiver als ReLU, was der Preis für die komplexere Mathematik ist.
Für mich war besonders wertvoll, die Aktivierungsfunktionen nicht nur anhand einer Accuracy-Zahl zu vergleichen. Erst die Kombination aus Lernkurven, Gradienten und Laufzeiten zeigt, was ein Ansatz in diesen Experimenten leistet und wo seine Grenzen liegen.